
Du willst nur die Datei? Der Generator unten baut sie dir aus angeklickten Optionen — inklusive der
User-agent-Blöcke für KI-Crawler — und widerspricht bei den zwei Häkchen, die regelmäßig Produktseiten aus dem Index kippen. → Direkt zum Generator
Die robots.txt ist die Datei, die man einmal anlegt und danach nie wieder liest. Zwanzig Zeilen, irgendwann aus einem Forenbeitrag kopiert, seitdem unverändert — und weil nie jemand eine Fehlermeldung bekommt, fällt auch nichts auf.
Dabei sind zwei Dinge auffällig, die ich in fast jedem Shopware-Shop wiederfinde. Das erste: robots.txt nimmt keine einzige Seite aus dem Index. Das zweite: eine der häufigsten Zeilen in Shopware-Shops sperrt genau nichts.
robots.txt-Generator für Shopware
Klick zusammen, was gesperrt sein soll, und kopier das Ergebnis in die Administration. Der Generator löst dabei die Frage auf, an der die meisten von Hand geschriebenen Dateien scheitern — ob deine Pfade an der Wurzel liegen oder hinter einem Sprachpräfix — und er meldet sich, wenn du die technischen Produkt-URLs oder alle Query-String-Seiten aussperrst.
Was er dir nicht abnehmen kann, sind zwei Entscheidungen: ob du Filterseiten auffindbar haben willst, und wie du zu KI-Crawlern stehst.
robots.txt-Konfigurator
Optionen anklicken, Datei kopieren — mit Hinweis, wo es weh tut
Ein Pfad je Zeile
Deine robots.txt
# robots.txt · erzeugt auf novastrix.com
# Vor dem Ausrollen in der Search Console gegenprüfen.

User-agent: *
Allow: /

# Technische und personalisierte Bereiche
Disallow: /account/
Disallow: /checkout/
Disallow: /widgets/
Disallow: /navigation/
Disallow: /bundles/
Disallow: /_profiler/
Allow: /widgets/cms/
Allow: /widgets/menu/offcanvas

# Rechtstexte — $ verankert exakt auf das URL-Ende
Disallow: /impressum$
Disallow: /datenschutz$
Disallow: /agb$

# KI-Crawler: Training gesperrt, Suche erlaubt

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: Bytespider
Disallow: /

User-agent: Meta-ExternalAgent
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: Claude-User
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Perplexity-User
Allow: /
61 Zeilen · 987 Bytes
- Die Rechtstexte werden mit $ verankert. /impressum$ trifft genau diese URL — /impressum/ mit Schrägstrich und /impressum?foo=1 bleiben crawlbar.
- Ohne Domain wird keine Sitemap-Zeile ausgegeben.
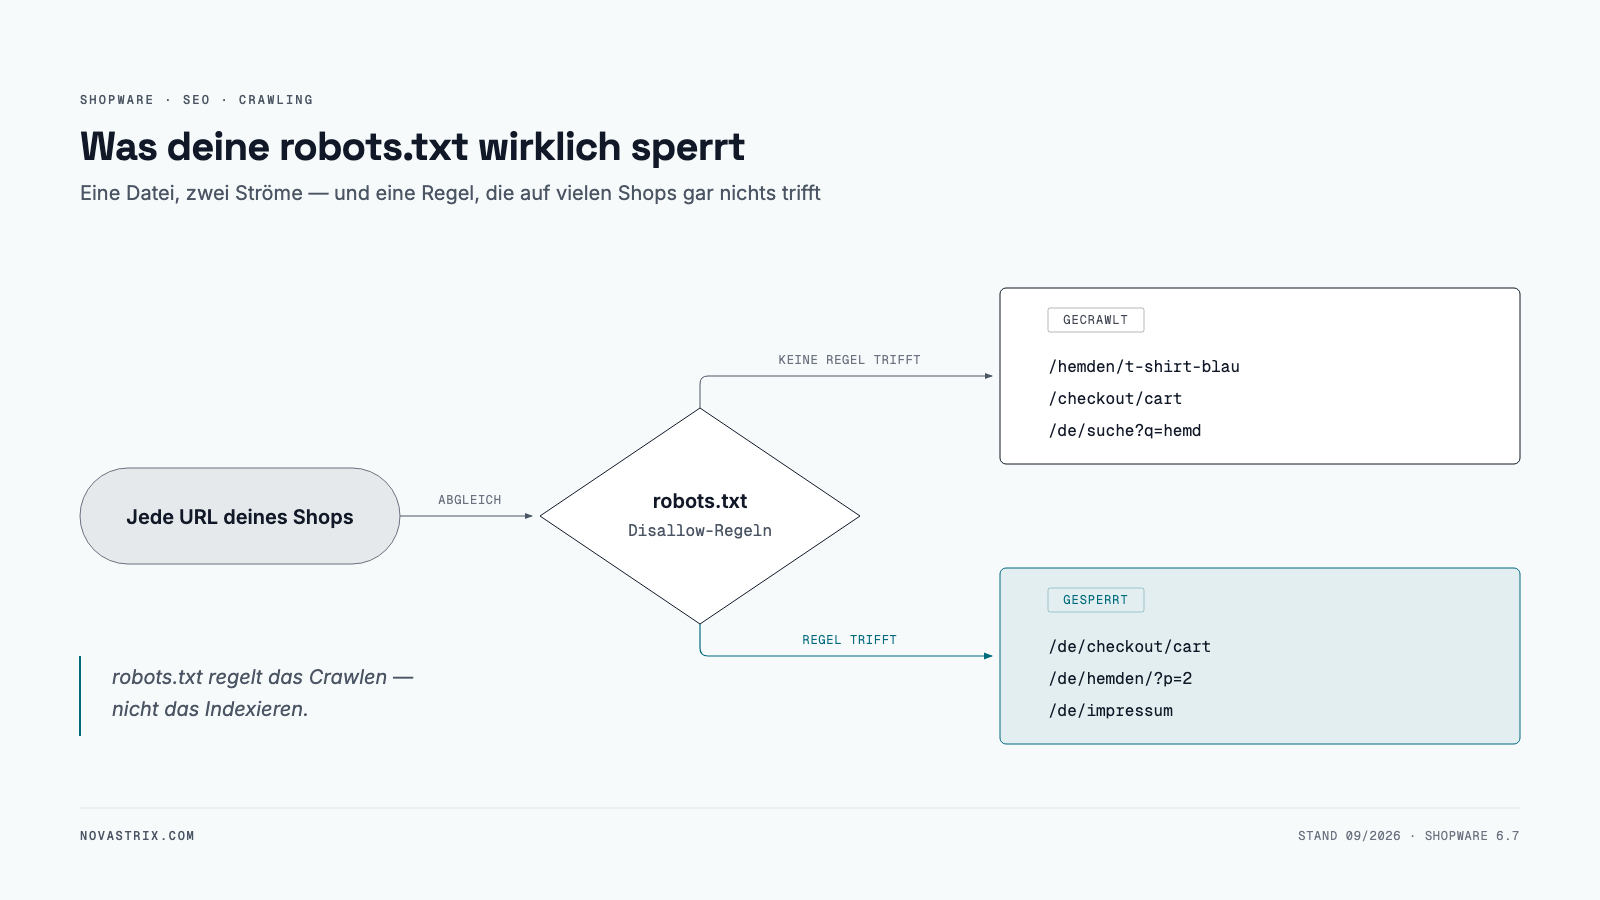
- robots.txt regelt das Crawlen, nicht das Indexieren. Eine gesperrte URL kann ohne Snippet weiter in den Suchergebnissen stehen. Was raus soll, braucht noindex — und dafür muss die Seite crawlbar bleiben.
Wenn du wissen willst, warum diese Zeilen so aussehen — und warum eine davon auf vielen Shops wirkungslos bleibt — steht das in den nächsten vier Abschnitten. Ich habe mir die Datei eines Shopware-Shops dafür genauer angesehen, weil ich für den Selbsttest mit einem KI-Agenten wissen wollte, was Crawler dort überhaupt dürfen.
Was robots.txt kann — und was nicht
robots.txt regelt das Crawlen, nicht das Indexieren. Das ist kein Wortklauberei-Unterschied, sondern der Grund für die meisten Fehlkonfigurationen, die ich sehe.
Google formuliert es in der robots.txt-Spezifikation selbst so: Der Inhalt einer gesperrten Seite kann nicht indexiert werden — die URL selbst aber schon, und sie kann ohne Snippet in den Suchergebnissen stehen. Wer eine Seite aus dem Index haben will, braucht noindex.
Und daraus folgt die Falle. noindex steht im Meta-Tag oder im HTTP-Header der Seite. Ein Crawler, der die Seite nicht abrufen darf, liest diesen Hinweis nie. Sperrst du eine URL in der robots.txt, die schon im Index steht, friert du ihren Zustand ein statt sie zu entfernen. Die Reihenfolge ist deshalb immer dieselbe: erst noindex setzen und warten, bis die Seite verschwunden ist — danach sperren, wenn du den Crawl-Aufwand sparen willst.
Der zweite Punkt, der in Shops regelmäßig übersehen wird: robots.txt ist keine Zugriffskontrolle. Die Datei ist öffentlich lesbar und listet damit sogar auf, welche Pfade es gibt. Was nicht nach draußen darf, braucht ein Passwort oder eine IP-Sperre — keine Zeile in einer Textdatei, an die sich nur freiwillig gehalten wird.
Fünf Regeln, die das Verhalten bestimmen
Bevor eine einzelne Zeile Sinn ergibt, muss klar sein, wie sie gelesen wird.
1. Es gibt genau zwei Sonderzeichen. * steht für null oder mehr beliebige Zeichen, $ für das Ende der URL. Kein Regex, keine Zeichenklassen, keine Alternativen.
2. Pfade sind ein Präfix, kein Ordner. Disallow: /detail sperrt /detail/123 — aber eben auch /details-zum-versand. Wer einen Ordner meint, schreibt den Schrägstrich hinten mit dazu.
3. Pfade sind case-sensitiv, User-Agent-Namen nicht. Disallow: /Account/ lässt /account/ frei durch. Umgekehrt ist es bei den Bot-Namen egal: googlebot, Googlebot und GOOGLEBOT bezeichnen denselben Crawler.
4. Die längste passende Regel gewinnt. Nicht die erste, nicht die letzte. Kollidieren Allow und Disallow bei gleicher Länge, entscheidet Google für die weniger restriktive — also für Allow. Die Reihenfolge der Zeilen in der Datei spielt keine Rolle.
5. Je Crawler gilt genau eine Gruppe. Ein Crawler sucht sich den spezifischsten passenden User-agent-Block und ignoriert alle anderen — auch User-agent: *. Die Blöcke summieren sich nicht. Das ist die Regel, an der die meisten selbstgebauten Dateien scheitern, und ich komme unten darauf zurück.
Dazu noch zwei Kleinigkeiten: crawl-delay wertet Google nicht aus, und ab 500 KiB Dateigröße wird der Rest ignoriert — letzteres wird für einen Shop nie relevant.
In der Tabelle zusammengefasst:
| Regel | trifft | trifft nicht |
|---|---|---|
Disallow: /checkout/ | /checkout/cart | /de/checkout/cart |
Disallow: /*/checkout/ | /de/checkout/cart | /checkout/cart |
Disallow: /detail | /detail/a1b2, /details-zum-versand | /de/detail/a1b2 |
Disallow: /impressum$ | /impressum | /impressum/, /impressum?x=1 |
Disallow: /*? | /suche?q=hemd | /suche |
Disallow: /*/? | /de/hemden/?p=2 | /de/suche?q=hemd |
Disallow: /Account/ | /Account/ | /account/ |
Die letzten drei Zeilen sind keine Spitzfindigkeiten. Sie erklären die Befunde im nächsten Abschnitt.
Eine echte Shopware-robots.txt, Zeile für Zeile
Das Folgende ist eine Datei, die ich so oder fast so immer wieder sehe — Shopware-Basis aus der Dokumentation, über die Jahre um deutsche Pfade und ein paar Sonderfälle ergänzt. Gekürzt auf einen User-agent-Block, im Original stand derselbe Inhalt dreimal:
User-agent: *
Allow: /
Allow: /*?affiliateCode=GoogleShopping
Disallow: /*/?
Disallow: /*/account/
Disallow: /*/checkout/
Disallow: /*/widgets/
Disallow: /*/navigation/
Disallow: /*/bundles/
Disallow: /*/_profiler/
Disallow: /*/kunde/
Disallow: /*/rechtlich/
Disallow: /*/app-system/
Disallow: /*/theme/
Disallow: /*/impressum$
Disallow: /*/datenschutz$
Disallow: /*/agb$
Disallow: /*/detail/

User-agent: Googlebot
[identisch]

User-agent: Googlebot-image
[identisch]

Sitemap: https://shop.de/sitemap.xml
Auf den ersten Blick sauber. Die Absicht ist überall erkennbar, die Syntax stimmt, es gibt keinen Tippfehler. Und trotzdem stecken hier vier Befunde drin, von denen drei etwas kosten.
Befund 1: Das /*/-Präfix verlangt ein Pfadsegment. Und zwar mindestens eines. Disallow: /*/checkout/ liest sich als „Schrägstrich, irgendwas, /checkout/" — und /checkout/cart erfüllt das nicht, weil nach dem ersten Schrägstrich kein zweiter mehr vor checkout kommt. Die Zeile greift auf /de/checkout/cart. Auf /checkout/cart greift sie nicht.
Das ist genau dann folgenlos, wenn jede Verkaufskanal-Domain ein Sprachpräfix im Pfad hat. Es ist eine offene Tür, sobald ein Kanal denselben Shop auch an der Wurzel ausliefert — der klassische Fall ist die Hauptsprache ohne Präfix und die Zweitsprache unter /en/. Dann sind Kundenkonto, Checkout und Profiler für die Hauptsprache schlicht nicht gesperrt.
So prüfst du es. Schau nach, welche URL dein Shop für den Warenkorb ausgibt, und halte sie gegen die Regel:
curl -sI https://shop.de/checkout/cart | head -1
curl -sI https://shop.de/de/checkout/cart | head -1
Antwortet die erste Variante mit 200, brauchst du die Regel ohne Präfix. Die Shopware-Dokumentation schreibt diese Zeilen übrigens mit führendem Stern (*/checkout/), was beide Fälle abdecken würde. Googles Spezifikation verlangt allerdings einen Pfad, der mit / beginnt — ein führender Stern ist damit Auslegungssache des jeweiligen Parsers. Wer nichts der Auslegung überlassen will, schreibt beide Varianten aus:
Disallow: /checkout/
Disallow: /de/checkout/
Zwei Zeilen statt einer, dafür keine Interpretation. Genau das macht der Konfigurator weiter unten, wenn du „beides absichern" wählst.
Befund 2: Drei identische Blöcke sind drei Baustellen. Weil je Crawler nur die spezifischste Gruppe gilt (Regel 5), liest Googlebot ausschließlich seinen eigenen Block und ignoriert User-agent: * vollständig. Solange alle drei Blöcke identisch sind, fällt das nicht auf. Es fällt beim ersten Mal auf, wenn jemand eine Zeile ergänzt und dabei nur den obersten Block anfasst: Dann folgt Googlebot weiter der alten Fassung — ohne Warnung, ohne Eintrag irgendwo.
Ein eigener Block ist nur dann richtig, wenn die Regeln für diesen Crawler wirklich andere sind. Sonst: ein User-agent: *-Block, fertig.
Befund 3: Disallow: /*/detail/ sperrt die Produktseiten. /detail/<id> ist in Shopware die technische Produkt-URL, die auch dann funktioniert, wenn keine SEO-URL existiert. Sie zu sperren ist als Duplicate-Content-Hygiene vertretbar — solange für jedes Produkt eine SEO-URL erzeugt wurde. Fehlt eine, weil das URL-Template geändert wurde oder der Warmup nicht durchgelaufen ist, dann ist dieses Produkt für Suchmaschinen nicht vorhanden.
Und hier schließt sich der Kreis zum ersten Abschnitt: Steht eine /detail/-URL schon im Index, holt die Sperre sie nicht mehr heraus. Sie verhindert nur noch, dass Google das noindex liest, mit dem du sie entfernen wolltest.
Befund 4: Keine Zeile zu KI-Crawlern. Kein GPTBot, kein ClaudeBot, kein OAI-SearchBot. Das ist keine Nachlässigkeit des Betreibers — Shopware kennt diese Namen ab Werk nirgends. Welche Haltung hier sinnvoll ist, welche Crawler trainieren und welche Antworten belegen, habe ich im Selbsttest mit einem KI-Agenten unter Prüfpunkt 5 mit Zahlen hinterlegt. Der Konfigurator unten schreibt dir die Blöcke direkt mit.
Und was hier richtig ist. Zwei Dinge, die nach Fehler aussehen und keiner sind. Googlebot-image klein geschrieben ist in Ordnung, weil Crawler-Namen case-insensitiv verglichen werden. Und Allow: /*?affiliateCode=GoogleShopping funktioniert tatsächlich gegen Disallow: /*/? — bei https://shop.de/de/hemden/?affiliateCode=GoogleShopping passen beide Regeln, und die längere gewinnt. Das ist Regel 4 in freier Wildbahn.
Ein Detail am Rande, das zeigt, wie genau man hier lesen muss: Disallow: /*/? ist nicht dasselbe wie das Disallow: /*? aus der Shopware-Standarddatei. Die Variante mit zwei Schrägstrichen greift nur, wenn dem Fragezeichen ein Schrägstrich direkt vorangeht. /de/suche?q=hemd bleibt damit crawlbar, /de/hemden/?p=2 nicht.
Wo die Datei in Shopware liegt
Seit 6.7.1 pflegst du die Regeln in der Administration, pro Domain: Einstellungen → Grundeinstellungen. Die Shopware-Dokumentation beschreibt das Feld, die Entwicklerdokumentation die Events, mit denen ein Plugin eigene Direktiven ergänzt.
Vor 6.7.1 gibt es zwei Wege. Eine statische Datei unter public/robots.txt — bei mehreren Domains mit einem Rewrite in der .htaccess auf eine Datei je Host:
RewriteRule ^robots\.txt$ robots/%{HTTP_HOST}.txt
Darunter dann public/robots/shop.de.txt, public/robots/shop.at.txt und so weiter. Der zweite Weg ist FroshRobotsTxt, das die Pflege in die Administration holt.
Eine Falle beim Admin-Feld musst du kennen, bevor du dort etwas einträgst: Der Wert auf Verkaufskanal-Ebene ist ein Ersatz, keine Ergänzung. Schreibst du dort deine eigenen Zeilen hinein, verschwinden die geerbten — ohne Warnung. Ich habe das gemessen und im Selbsttest-Beitrag dokumentiert, samt der fünf Zeilen, die du mitkopieren musst.
Gegenprüfen, nicht hoffen
Eine robots.txt, die man nur gelesen hat, ist nicht geprüft. Drei Schritte, in dieser Reihenfolge:
Steht die Datei so da, wie du sie gespeichert hast? Wenn du keine Shell öffnen willst: Trag deine Domain in den Agenten-Check ein — er holt deine /robots.txt live, sagt dir, ob sie überhaupt antwortet, und ob sie die KI-Crawler kennt. Auf der Kommandozeile geht dasselbe so:
curl -s https://shop.de/robots.txt
Klingt banal, ist aber der Schritt, der die „Ersatz statt Ergänzung"-Falle aus dem vorigen Abschnitt sichtbar macht — dort fehlen nach dem Speichern plötzlich Zeilen, die du nie angefasst hast.
Liest Google dieselbe Datei? In der Search Console unter Einstellungen → robots.txt steht, welche Fassung Google zuletzt geholt hat, wann, und ob sie fehlerfrei geparst wurde. Ein alter Stand hier erklärt ein Verhalten, das zur aktuellen Datei nicht passt.
Ist die eine URL erreichbar, auf die es ankommt? Die URL-Prüfung der Search Console sagt für eine konkrete Adresse, ob sie crawlbar ist. Nimm eine echte Produkt-URL und, falls du /detail/ gesperrt hast, zusätzlich die technische Variante desselben Produkts.
Und wenn du etwas bewusst freigegeben hast, prüfe, dass es auch antwortet:
for p in / /hemden/ /hemden/?p=2 /detail/a1b2c3; do
  printf '%s %s\n' "$(curl -s -o /dev/null -w '%{http_code}' "https://shop.de$p")" "$p"
done
Das prüft die Erreichbarkeit für Menschen — robots.txt hält niemanden ab, der die URL direkt aufruft. Beides zusammen, Abruf und Search-Console-Prüfung, ergibt erst das vollständige Bild.
Häufige Fragen
Sperrt robots.txt eine Seite aus dem Google-Index?
Nein. robots.txt regelt nur, ob eine URL abgerufen werden darf. Google kann eine gesperrte URL weiterhin indexieren und ohne Snippet in den Ergebnissen zeigen — die Inhalte fehlen dann, die Adresse nicht. Wer eine Seite aus dem Index haben will, braucht noindex im Meta-Tag oder HTTP-Header, und die Seite muss dafür crawlbar bleiben.
Warum wirkt meine Disallow-Zeile nicht?
Drei Ursachen deckt das in fast allen Fällen ab. Erstens das /*/-Präfix: Es verlangt mindestens ein Pfadsegment, /*/checkout/ greift also nicht auf /checkout/cart. Zweitens die Groß- und Kleinschreibung — Pfade sind case-sensitiv, /Account/ sperrt /account/ nicht. Drittens eine längere Allow-Regel, die gewinnt, weil nicht die Reihenfolge entscheidet, sondern die Länge des Regelpfads.
Wo pflege ich die robots.txt in Shopware 6?
Ab 6.7.1 pro Domain in der Administration unter Einstellungen → Grundeinstellungen. Davor als statische Datei unter public/robots.txt, bei mehreren Domains über einen .htaccess-Rewrite oder das Plugin FroshRobotsTxt. Achtung beim Admin-Feld: Der Wert auf Verkaufskanal-Ebene ersetzt den geerbten, er ergänzt ihn nicht.
Soll ich GPTBot und ClaudeBot sperren?
Die verbreitete Antwort lautet „block training, allow search": Trainings-Crawler wie GPTBot, ClaudeBot und CCBot sperren, Such- und Abruf-Crawler wie OAI-SearchBot oder PerplexityBot zulassen. Die Logik dahinter ist, dass Training nichts zurückbringt, Suche aber Besucher. Der Generator oben schreibt dir beide Varianten. Die Zahlen und Verhältnisse dazu stehen im Selbsttest.
Was passiert, wenn ich /detail/ sperre?
/detail/<id> ist die technische Produkt-URL in Shopware, die auch ohne SEO-URL funktioniert. Die Sperre ist als Duplicate-Content-Hygiene vertretbar, solange für jedes Produkt eine SEO-URL existiert. Fehlt eine, ist dieses Produkt für Suchmaschinen weg — und weil eine gesperrte URL kein noindex mehr ausliefern kann, bekommst du sie auch nicht mehr sauber aus dem Index.
Kurzer Hinweis
robots.txt ist ein freiwilliger Standard. Die großen Anbieter erklären, sich daran zu halten, und tun das nach allem, was messbar ist, auch — aber es gibt keinen technischen Mechanismus, der einen nicht-konformen Crawler aufhält. Wer verbindlich aussperren muss, braucht eine Sperre auf Server- oder WAF-Ebene.
Die Angaben zu Shopware beziehen sich auf den Stand vom 29. September 2026 und auf 6.7.x. Die Namen der KI-Crawler ändern sich schneller als jede andere Zeile in dieser Datei — ein Blick pro Quartal reicht, aber ganz ohne geht es nicht. Und das hier ist SEO-Handwerk, keine Rechtsberatung: Ob das Aussperren von Trainings-Crawlern in deinem Fall zusätzlich eine Erklärung nach Urheberrecht braucht, klärt eine Anwältin oder ein Anwalt.
Nächster Schritt
- Die eigene Datei einmal ganz lesen — per
curl -s https://dein-shop.de/robots.txtoder über den Agenten-Check, der sie für dich holt. Meistens steht dort etwas, das niemand mehr erklären kann. - Jede
/*/-Zeile gegen die echten URLs halten. Wenn dein Shop an der Wurzel ausliefert, fehlen dir die Regeln ohne Präfix. - Doppelte
User-agent-Blöcke zusammenführen, solange die Regeln darin identisch sind. /detail/nur sperren, wenn du nachgesehen hast, dass jedes Produkt eine SEO-URL hat.- Eine Haltung zu KI-Crawlern eintragen — die Zahlen dazu stehen im Selbsttest.
- In der Search Console gegenprüfen, nicht im Browser-Tab.
Wenn dein Katalog größer ist als das, was man von Hand durchklickt — fehlende SEO-URLs, fehlende Eigenschaften, fehlende Lieferzeiten — dann zählt das Produktdaten-Audit genau das über den gesamten Katalog aus.
Und wenn du die robots.txt lieber einmal gemeinsam durchgehen willst, statt sie zu erraten: meld dich.


